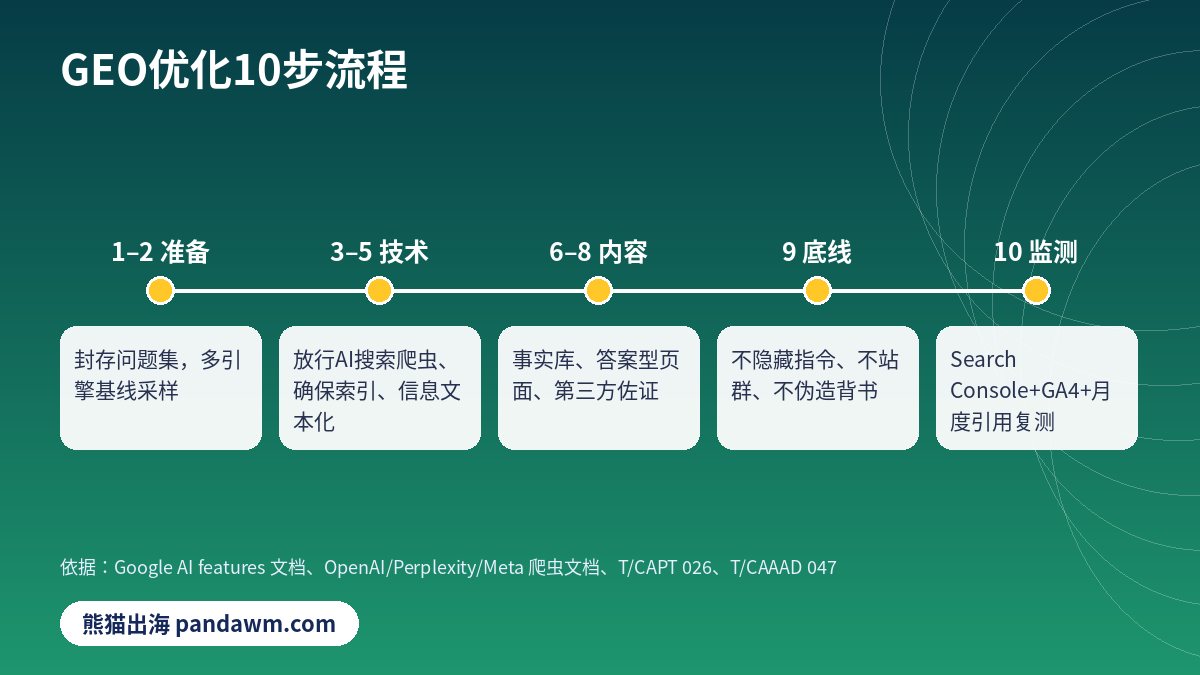
GEO 优化怎么做?答案先放前面:先让 AI 搜索“抓得到、读得懂”,再给它“可引用的事实”,最后用多次采样证明“确实被引用了”。拆成 10 步就是:问题集 → 基线 → 放行 AI 搜索爬虫 → 确保被索引 → 关键信息文本化 → 建事实库 → 写答案型页面 → 争取第三方佐证 → 避开操纵行为 → 监测迭代。Google 官方明确说明:出现在 AI Overviews 和 AI Mode 没有额外的技术要求,页面只需被索引且有资格显示摘要(Google:AI features and your website);ChatGPT 搜索则要求你别屏蔽 OAI-SearchBot(OpenAI:Overview of crawlers)。本文面向做海外市场的官网/独立站,概念部分见支柱页什么是 GEO。
一、准备:先定问题、再测基线(第 1–2 步)
1.1 第 1 步:建立并封存“意图问题集”
不要从“我想上哪个词”出发,而从海外买家会问 AI 的问题出发。中国广告协会 10 月 23 日实施的 T/CAAAD 047 建议问题集覆盖品牌词、产品词、品类词、场景词、问题词、比较词、决策词、售后词、风险词和竞品词,并在基线监测前双方确认并封存,中途不擅自改写(T/CAAAD 047 第 7 章)。
| 类型 | 英文市场示例(以工业设备为例) |
|---|---|
| 品类词 | best industrial chiller manufacturers |
| 场景词 | chiller for injection molding 50 ton |
| 比较词 | brand A vs brand B chiller |
| 风险词 | is brand A reliable / warranty |
| 决策词 | industrial chiller price per ton |
1.2 第 2 步:做基线采样
在目标引擎(ChatGPT、Gemini/Google AI Mode、Perplexity、Copilot 等)逐条提问并保存完整回答与引用链接。T/CAAAD 047 的口径是:不以单次查询作为效果证明,正式验证宜不少于 3 个时间窗口、单一关键指标不少于 30 次有效观测;目标引擎模型重大升级时要重建基线(T/CAAAD 047 第 8 章)。
二、技术:让 AI 搜索抓得到(第 3–5 步)
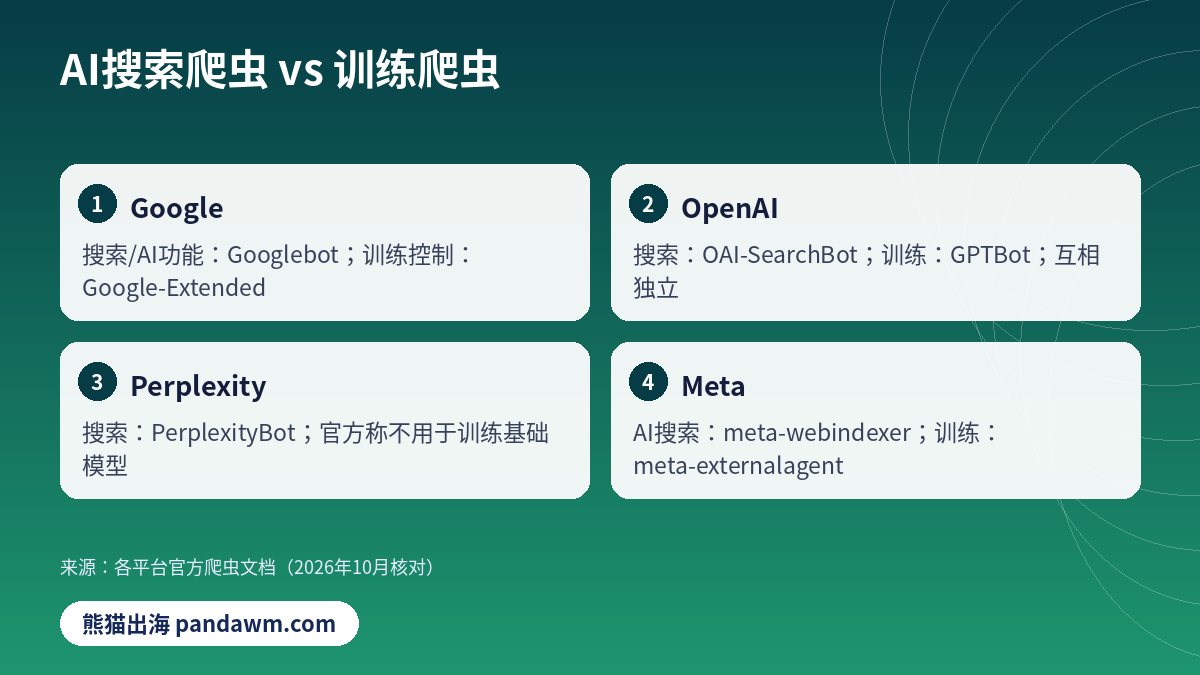
2.1 第 3 步:robots.txt 与 CDN/WAF 放行“搜索类”爬虫
| 平台 | 用于 AI 搜索引用 | 用于模型训练 | 官方说明要点 |
|---|---|---|---|
| Googlebot(AI 功能随搜索抓取) | Google-Extended(控制部分其他系统训练与 grounding) | AI Overviews/AI Mode 由 Googlebot 规则控制 | |
| OpenAI | OAI-SearchBot | GPTBot | 屏蔽 OAI-SearchBot 的站点不会出现在 ChatGPT 搜索答案中;修改约 24 小时生效 |
| Perplexity | PerplexityBot | —(官方称不用于训练基础模型) | 建议放行并允许其公布的 IP 段;约 24 小时生效 |
| Meta | meta-webindexer | meta-externalagent | 允许 webindexer 有助于 Meta AI 引用并链接你的内容 |
(Google、OpenAI、Perplexity、Meta)关键是分开处理“搜索引用”和“训练”:可以放行 OAI-SearchBot、屏蔽 GPTBot,两者互相独立。很多出海站点的问题不是 robots.txt,而是 Cloudflare 等 WAF 默认拦截了这些爬虫,Google 也提醒要确保“robots.txt 以及任何 CDN 或托管设施”都允许抓取(Google)。
2.2 第 4 步:确保被索引,并主动推送更新
- 在 Google Search Console 验证网站、提交站点地图,用网址检查确认页面已编入索引——这是进入 AI Overviews/AI Mode 的前提;
- Bing 生态(含 Copilot)可用 IndexNow 推送新增、更新或删除的 URL;密钥要求为 8–128 位十六进制字符(IndexNow 文档);
- 多语言站点为每种语言准备独立 URL 并互相标注,避免 AI 引用到错误语言版本。
2.3 第 5 步:关键信息“文本化 + 结构化一致”
Google 列出的基础做法包括:重要内容以文本形式呈现、用内部链接让内容易被发现、结构化数据与页面可见文本一致,并保持 Merchant Center 与商家资料最新;同时说明不需要为 AI 功能创建新的机器可读文件、AI 文本文件或特殊 schema(Google)。所以 llms.txt 可以作为可选项,但不要把它当成“必做”。把参数表、价格(统一用 USD 标注)、认证、交期写成 HTML 文本,而不是只放在图片或 PDF 里。
三、内容:让 AI 读得懂、愿意引用(第 6–8 步)
3.1 第 6 步:建立“事实库”,与营销文案分开
T/CAPT 026 提出“三区分治”:事实库、观点库、营销表达库分开管理,营销表达中的事实以事实库版本为准;每条核心事实至少绑定来源等级、来源名称、原始链接、采集时间、最近核验时间、审核责任人、有效期、版本号、证据文件编号 9 项要素(T/CAPT 026 第 6.2、7.1 条)。落到官网,就是一张持续更新的“产品事实页/规格页/FAQ 页”。
3.2 第 7 步:写“答案型”页面
- 首段直接回答问题(像本文这样),再展开理由;
- 用对比表、决策表回答“A vs B”“哪个适合我”;
- 每页覆盖一个明确意图,FAQ 用真实买家问题;
- 标明作者、更新日期与数据来源——Google 有用内容指南建议从 “Who、How、Why” 自查内容(Creating helpful, reliable, people-first content)。
3.3 第 8 步:争取第三方佐证
在 T/CAPT 026 的来源分级里,企业官网、产品手册属 C 级(辅助来源),主流媒体原创报道、行业协会白皮书属 B 级(重要证据来源)(T/CAPT 026 表 1)。AI 回答“谁最好”时,往往需要独立来源交叉印证:行业媒体报道、协会名录、真实客户评价平台、展会与认证机构页面都比自家重复宣传更有分量。
四、底线:第 9 步——不做这些事
| 做法 | 为什么不做 | 依据 |
|---|---|---|
| 隐藏文本、CSS 隐藏指令、提示词注入 | 属于操纵行为,被国内标准点名,也是搜索垃圾政策打击对象 | T/CAPT 026 第 7.3 条;Google 垃圾政策 |
| 站群、批量生成相似页面 | 可能构成“规模化内容滥用”与伪共识 | Google spam policies;T/CAPT 026 术语 3.10 |
| 伪造评价、榜单、媒体背书 | 虚假信息,风险远大于收益 | T/CAPT 026 第 4.2 条 |
| 承诺“保证 AI 首位推荐” | 不当效果承诺 | T/CAAAD 046 第 7.1.4 条 |
(Google Search 垃圾政策,2026-08-28 更新)。GEO 服务商的承诺边界可对照GEO 服务不能承诺什么。
五、第 10 步:监测与迭代
- Search Console:出现在 AI Overviews/AI Mode 的流量计入效果报告的 “Web” 搜索类型(Google);
- GA4:按引荐来源查看来自 chatgpt.com、perplexity.ai、copilot 等域名的会话与转化;
- 引用监测:按封存问题集每月至少 3 个时间窗口复测,记录品牌提及率、目标信源出现率、回答准确率与负面误引率;
- 迭代:被误引的事实优先在事实库更正,再补充第三方来源。
开源监测与审计工具可参考GEO 优化 GitHub 开源项目盘点;多久能看到信号见GEO 项目 3/30/90 天信号。
六、常见问题(FAQ)
6.1 GEO 优化怎么做,第一步是什么?
先建立并封存海外买家真实会问的问题集,再做基线采样;没有基线就无法证明后续优化有效。
6.2 做 GEO 必须加 llms.txt 吗?
不是必须。Google 明确说明出现在 AI 功能中不需要新的 AI 文本文件或特殊结构化数据;llms.txt 可作为可选补充。
6.3 屏蔽 GPTBot 会影响 ChatGPT 搜索引用吗?
OpenAI 说明 OAI-SearchBot 与 GPTBot 的设置相互独立:放行 OAI-SearchBot、屏蔽 GPTBot,仍可出现在 ChatGPT 搜索结果中。
6.4 GEO 和 SEO 是什么关系?
对 Google 而言,AI Overviews/AI Mode 沿用 SEO 基础与搜索政策;GEO 额外强调可引用的事实资产、第三方佐证与 AI 回答监测。
6.5 GEO 多久见效?
取决于抓取与索引周期和第三方来源积累;按 T/CAAAD 047 口径,至少要跨 3 个时间窗口重复采样才能下结论。
七、结语
GEO 不是一套“让 AI 说你好话”的话术,而是技术可抓取 + 事实可核验 + 来源可佐证 + 效果可复测的工程。熊猫出海提供多语言官网建设、GEO 事实库与 AI 引用监测,面向出海企业按 10 步交付,欢迎访问熊猫出海咨询。
 微信扫一扫打赏
 支付宝扫一扫打赏