最后更新:2026-10-22
AI大模型破甲是中文网络对“大模型越狱”(Jailbreak)的俗称:攻击者用特殊构造的输入,让模型绕过开发方设定的安全限制,输出本不该输出的内容。它与提示词注入(Prompt Injection)关系密切——OWASP 在《大语言模型应用十大风险(2025)》中把提示词注入列为第一位(LLM01),并把越狱视为提示词注入的一种形式(OWASP LLM01:2025 Prompt Injection)。结论先说:提示词注入目前没有一劳永逸的解法,英国国家网络安全中心(NCSC)也指出它是当前大模型最广为报道的安全弱点之一(NCSC);出海 AI 企业能做的是分层防护——输入输出过滤、系统提示词隔离、工具最小权限、高影响动作人工确认、红队测试与日志监控。本文只做科普与防护,不提供任何可用的攻击提示词。
相关阅读:AI 智能体怎么选见2026 AI 智能体对比,常见术语见出海广告与 AI 术语表。
一、什么是AI大模型破甲(大模型越狱)?
1.1 破甲、越狱、提示词注入三个词的区别
| 名词 | 含义 | 典型后果 | 权威出处 |
|---|---|---|---|
| 大模型破甲(中文俗称) | 让模型突破安全护栏的行为统称 | 输出有害、违规或不当内容 | 中文社区用语,对应 Jailbreak |
| 越狱(Jailbreak) | 直接通过输入让模型忽略安全规则 | 绕过内容安全策略 | OWASP LLM01;MITRE ATLAS 收录“LLM Jailbreak”技术 |
| 提示词注入(Prompt Injection) | 输入改变了模型原本的行为或输出,可直接或间接发生 | 泄露数据、执行越权操作、输出被操控 | OWASP LLM01:2025 |
| 间接提示词注入 | 恶意指令藏在模型读取的网页、文件、邮件等外部内容里 | 智能体被“遥控” | OWASP LLM01;Microsoft 称为 document attack |
1.2 为什么大模型容易被“破甲”
根本原因是大模型把指令和数据放在同一段文本里处理,很难像传统软件那样严格区分“代码”和“输入”。NCSC 将提示词注入描述为“用户构造输入,使模型以非预期方式运行”,并提到已有数百个公开案例(NCSC:Thinking about the security of AI systems)。美国 NIST 在《生成式 AI 风险画像》(NIST AI 600-1,2024 年 7 月)中也把直接与间接提示词注入列为信息安全风险(NIST AI 600-1)。
二、5类常见攻击类型(概念层面)
以下只说明原理和风险,不给出任何可复制的攻击语句。
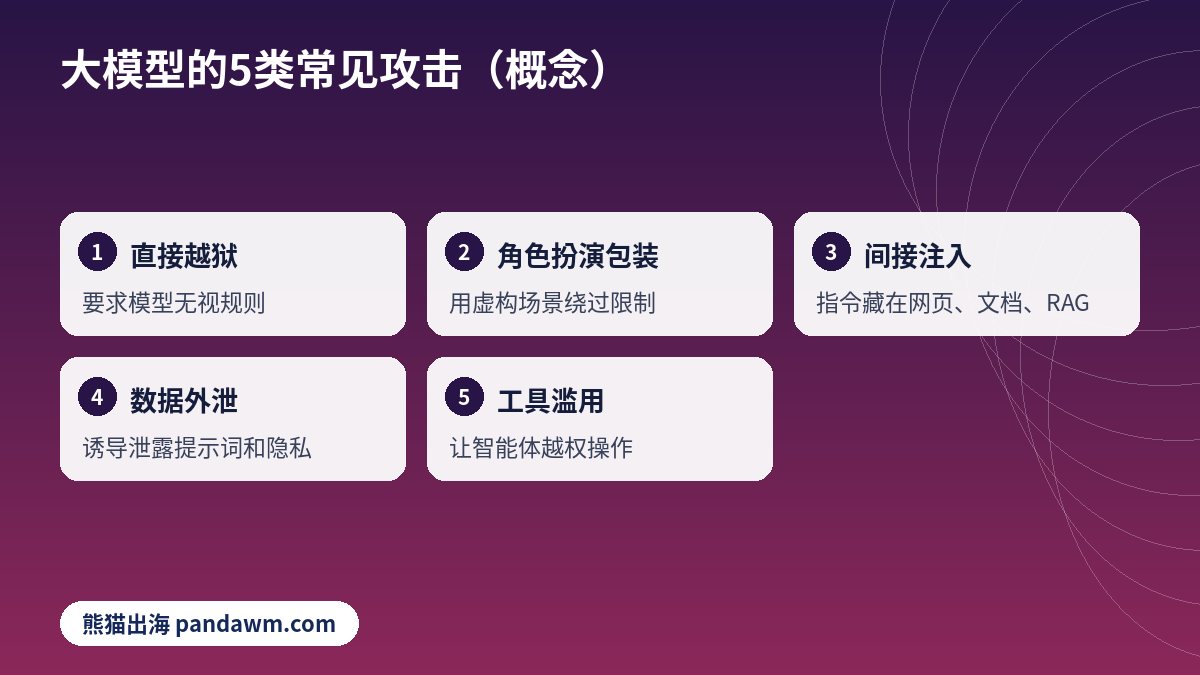
2.1 直接越狱
用户在对话框里直接要求模型无视规则,或用多轮对话逐步诱导。风险是模型输出违反平台政策的内容,给品牌带来合规与声誉问题。
2.2 角色扮演与虚构包装
把违规请求包装成“故事”“游戏”“假设场景”,让模型误以为不受安全规则约束。这是越狱最常见的思路之一。
2.3 间接提示词注入(网页、文档、RAG)
恶意指令不来自用户,而是藏在模型读取的网页、PDF、邮件或知识库(RAG)里。OWASP 指出外部内容中的指令即使人看不见,模型也可能执行(OWASP)。对会联网、会读文档的客服机器人和智能体,这是最需要重视的一类。
2.4 数据外泄与系统提示词泄露
诱导模型吐出系统提示词、对话中的个人信息或知识库里的内部资料。OWASP 2025 版把“敏感信息泄露”(LLM02)和“系统提示词泄露”(LLM07)单独列出(OWASP Top 10 for LLM Applications 2025)。
2.5 工具与智能体滥用
模型能调用发邮件、下单、改数据库等工具时,注入攻击可能让它执行越权操作。OWASP 称之为“过度代理”(Excessive Agency,LLM06)。智能体权限越大,后果越严重。
三、权威机构怎么说:数据与框架
| 机构/资料 | 核心观点 | 对出海企业的意义 |
|---|---|---|
| OWASP LLM01:2025 | 提示词注入排第一;因模型的随机性,是否存在万无一失的防护尚不清楚 | 不要期待“一次配置永久安全”,要分层防护 |
| NIST AI 600-1 | 生成式 AI 专属风险画像,含直接/间接提示词注入 | 可作为风险评估清单,配合 NIST AI RMF |
| MITRE ATLAS | AI 系统对抗战术与技术知识库,收录提示词注入与越狱 | 红队测试时用来对照攻击面 |
| 英国 NCSC | 提示词注入是被广泛报道的弱点,已有数百个公开案例 | 把模型输出当作不可信输入处理 |
| Anthropic Constitutional Classifiers | 实验中无防护时高级越狱成功率 86%,加分类器后降到 4.4% | 护栏模型能显著降低风险,但不是零 |
| Microsoft Prompt Shields | 同时检测用户提示攻击和文档攻击 | 输入与外部文档都要检测 |
| Google SAIF | 安全 AI 框架,强调把传统安全控制延伸到 AI | 把 AI 纳入现有安全体系 |
真实案例方面,2024 年加拿大不列颠哥伦比亚省民事仲裁庭在 Moffatt v. Air Canada(2024 BCCRT 149)中裁定,航空公司要为官网聊天机器人给出的错误信息负责。这个案子不是攻击,但说明了一点:机器人说出的话,企业要承担后果。被“破甲”后输出的内容同样如此。
四、攻击类型与防护措施对照表(可引用)
| 攻击类型 | 主要风险 | 第一道防护 | 第二道防护 | 参考 |
|---|---|---|---|---|
| 直接越狱 | 违规内容、品牌受损 | 输入检测 + 护栏模型 | 输出内容安全过滤 | Anthropic、Microsoft |
| 角色扮演包装 | 绕过内容策略 | 系统提示词明确边界,拒绝改变身份 | 输出过滤 + 抽检 | Anthropic 文档 |
| 间接注入(网页/文档/RAG) | 智能体被外部内容操控 | 外部内容标记为数据、单独检测 | 限制可执行动作 | OWASP、Microsoft |
| 数据外泄/提示词泄露 | 个人信息、内部资料泄露 | 提示词不放机密;数据最小化 | 输出脱敏 + 日志告警 | OWASP LLM02/LLM07 |
| 工具与智能体滥用 | 越权操作、资金损失 | 最小权限、凭据不交给模型 | 高影响动作人工确认 | OWASP LLM06、OpenAI |
五、出海AI企业的jailbreak防护清单(8步)
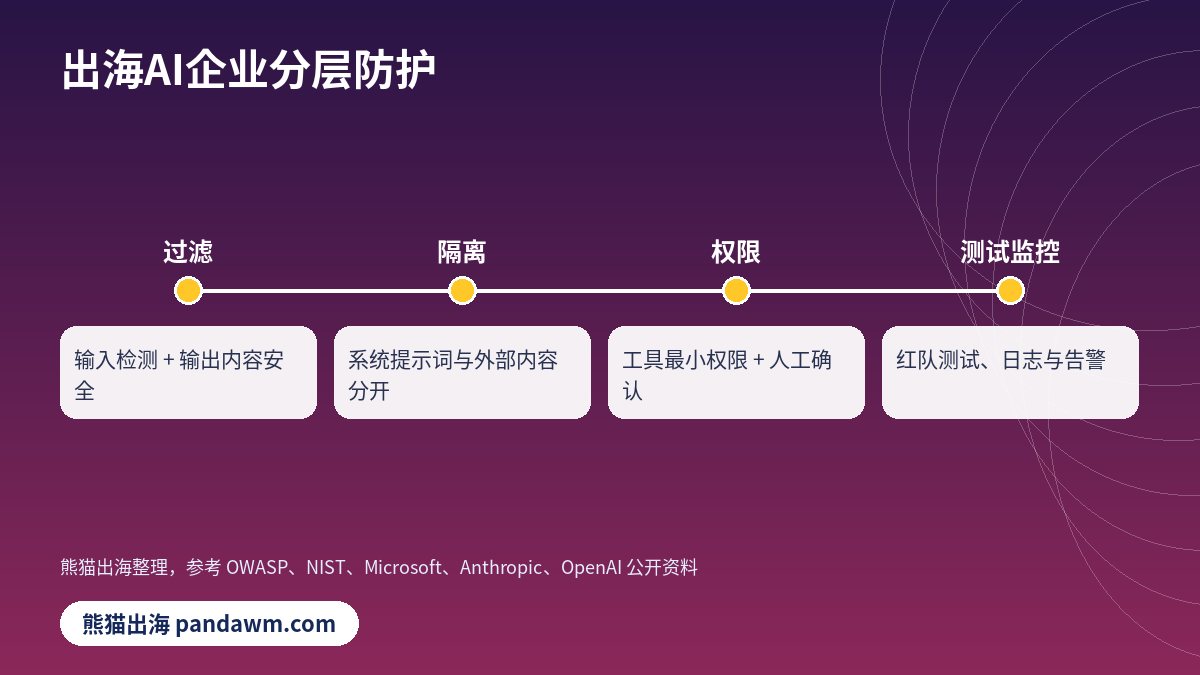
5.1 输入与输出双向过滤
用护栏模型或内容安全服务检测越狱和注入(如 Azure Prompt Shields),输出侧再做一次内容安全与敏感信息检查。OpenAI 也建议使用审核接口并限制输入输出长度(OpenAI Safety best practices)。
5.2 系统提示词隔离
假设系统提示词迟早会泄露:不放 API 密钥、内部网址和客户数据;用清晰的标记把开发者指令、用户输入和外部内容分开。
5.3 外部内容一律当“数据”
网页、文档、邮件和检索结果只作为参考资料,不能当成指令执行。这是防间接注入的核心原则。
5.4 工具最小权限
每个工具只给完成任务所需的最小权限,凭据放在服务端,不交给模型;读写分离,能只读就只读。
5.5 高影响动作人工确认
发邮件、付款、删除、对外发布等动作,由人确认后再执行。OpenAI 建议在可能的情况下保留“人工介入”(human in the loop)。
5.6 红队测试
上线前和每次换模型、改提示词后,按 OWASP 与 MITRE ATLAS 的攻击类别做测试。Anthropic 的文档也建议持续监控和迭代防护(Anthropic:Mitigate jailbreaks)。
5.7 日志与监控
记录提示词、工具调用和拦截结果,设置异常告警,便于追溯和复盘。注意日志里的个人信息也要按 GDPR 等法规处理。
5.8 合规:欧盟 AI 法案等
面向欧盟市场的 AI 产品要关注《欧盟人工智能法案》(Regulation (EU) 2024/1689):其第 15 条要求高风险 AI 系统具备准确性、稳健性和网络安全,并抵御利用系统漏洞改变其使用或输出的攻击;与用户交互的 AI 系统还有透明度义务(EUR-Lex:Regulation (EU) 2024/1689)。具体适用范围和生效时间请以官方文本和法律顾问意见为准。
六、大模型应用防护自查清单与评分器
- 系统提示词不含任何机密
- 外部内容与指令分开标记
- 输入侧有越狱/注入检测
- 输出侧有内容安全过滤和脱敏
- 工具按最小权限授权
- 高影响动作需要人工确认
- 上线前和变更后做红队测试
- 提示词与工具调用全量日志、异常告警
- 用户举报与应急下线流程
- 目标市场 AI 法规已梳理
大模型应用防护自查评分器(勾选你已经做到的项,得出 0–100 分;只在浏览器本地计算,不上传任何数据)
七、常见问题(FAQ)
7.1 AI大模型破甲是什么意思?
是“大模型越狱”(Jailbreak)的中文俗称,指通过构造输入让模型绕过安全限制。它属于提示词注入的一种形式(OWASP LLM01:2025)。
7.2 越狱和提示词注入有什么区别?
越狱侧重让模型无视安全规则;提示词注入范围更广,包括藏在网页、文档里的间接注入,可能导致数据泄露或越权操作。
7.3 提示词注入能被完全防住吗?
目前不能保证。OWASP 指出由于模型的随机性,是否存在万无一失的防护尚不清楚,所以要分层防护并持续测试。
7.4 企业客服机器人最该先做哪几项?
先做系统提示词不放机密、输入输出过滤、工具最小权限和高影响动作人工确认,再补红队测试和日志监控。
7.5 出海到欧盟要注意什么?
关注欧盟 AI 法案(Regulation (EU) 2024/1689)的透明度义务,以及高风险系统的稳健性和网络安全要求,同时遵守 GDPR。
八、熊猫出海可以提供什么帮助
熊猫出海是香港出海服务商,除海外广告投放、GEO/AI 搜索优化和多语言网站外,还可提供大模型安全评估与防护方案咨询:梳理 AI 客服、智能体的攻击面,对照 OWASP、NIST 等框架给出越狱与提示词注入的防护建议,并结合目标市场合规要求落地。欢迎访问熊猫出海官网联系我们。更多 AI 工具评测可看出海营销 AI 智能体推荐与广告平台开户费用对比。
引用本页:熊猫出海 pandawm.com《AI大模型破甲是什么?大模型越狱与提示词注入(Prompt Injection)科普:5类攻击原理、真实案例与出海AI企业jailbreak防护清单(附防护自查评分器,2026)》,https://www.pandawm.com/blog/llm-jailbreak-prompt-injection-defense-guide.html
 微信扫一扫打赏
 支付宝扫一扫打赏