熊猫出海编辑团队
最后更新:2026-11-03
先说结论:“GPT 破甲”是中文社区对“让 ChatGPT 绕过安全限制”的俗称,也就是常说的越狱(jailbreak)。本文不提供、也不转载任何破甲提示词或绕过步骤。原因很实际:公开评测显示流传很广的套路会随着厂商修补而失效;OpenAI 的使用条款禁止绕过其保护措施,可能带来账号处置;而所谓“破解版 GPT”站点还会带来数据泄露风险。下面讲清楚概念、风险和企业该怎么做。
一、GPT破甲、GPT越狱、ChatGPT破甲:说的是同一件事吗?
基本是。几个说法都指向同一类行为:通过精心构造的输入,让模型忽略厂商设定的安全规则。OWASP 把越狱描述为提示词注入的一种形式,即攻击者输入的内容让模型“完全无视”安全协议。术语的细分见 《AI破甲、越狱、破限与提示词注入的区别》,英文版概念解释见 What Is AI Jailbreaking?。
二、为什么“万能破甲词”撑不了多久
| 常见期待 | 公开研究显示的情况 |
|---|---|
| 有一条词能解锁一切 | JailbreakBench 的基线测试里,一类著名的角色扮演式模板在 GPT-3.5 和 GPT-4 上成功率为 0%,但在较弱的开源模型上仍可达 90% |
| 老办法一直有效 | JailbreakBench 附录提到,一种曾能迁移到 GPT 系列模型的对抗后缀攻击,在厂商安全补丁后成功率降到约 5%(评测时间为 2024 年 6 月 5 日) |
| 一种办法通吃所有模型 | HarmBench 比较了 18 种红队方法和 33 个模型/防御,结论是没有任何攻击或防御是“处处有效”的,结果因模型和行为类别而异 |
| 这是一把一次性的锁 | 厂商会叠加模型训练、独立分类器和账号侧检测;Anthropic 报告称其分类器方案在 1 万条合成测试提示上把越狱成功率从 86% 降到 4.4%(这是另一家厂商,但方向一致) |
也要客观:部分研究型攻击在某些模型上仍然有效,所以不能说“一定失败”。更重要的是,评测数字只是某个时间点、某个版本、某个裁判标准下的快照(HarmBench 发现仅输出长度设置就可使攻击成功率波动最多约 30%),不能当作今天的实际成功率。
三、违反条款意味着什么:账号风险
- OpenAI 使用条款(Terms of Use):不得规避服务中的限制或绕过保护措施、安全缓解措施;违反条款,OpenAI 可能暂停或终止访问。
- OpenAI 使用政策(Usage Policies):规定服务可用于什么、不可用于什么,建议在做产品前阅读当前版本。
- 其他厂商同类规定:Anthropic 使用政策禁止在未获事先授权的情况下有意绕过护栏(明确点名越狱与提示词注入),但也为获授权的安全工作(如漏洞赏金、其网络安全验证项目)留出渠道;Google 的 Gemma 使用限制禁止试图覆盖或规避安全过滤。
我们无法判断任何具体账号会被如何处理;企业工作区的账号被处置时,影响的是整个团队的使用。以上条款为我们 2026-11-03 查阅的公开页面,请以官方当前版本为准。
四、“破解版 GPT”“破甲站”的现实风险
| 风险 | 说明 |
|---|---|
| 数据泄露 | 你输入的内容会交给身份不明的运营方,包括公司资料、客户信息、源代码 |
| 凭证与付款风险 | 要求提供 API Key、账号密码或付费的站点,可能是诈骗或盗用 |
| 输出不可靠 | 即使模型“照做”,内容的准确性并不会提高,还可能编造 |
| 合规责任 | 员工用此类站点处理公司数据,通常违反公司的数据安全制度 |
五、企业该怎么做:两类场景
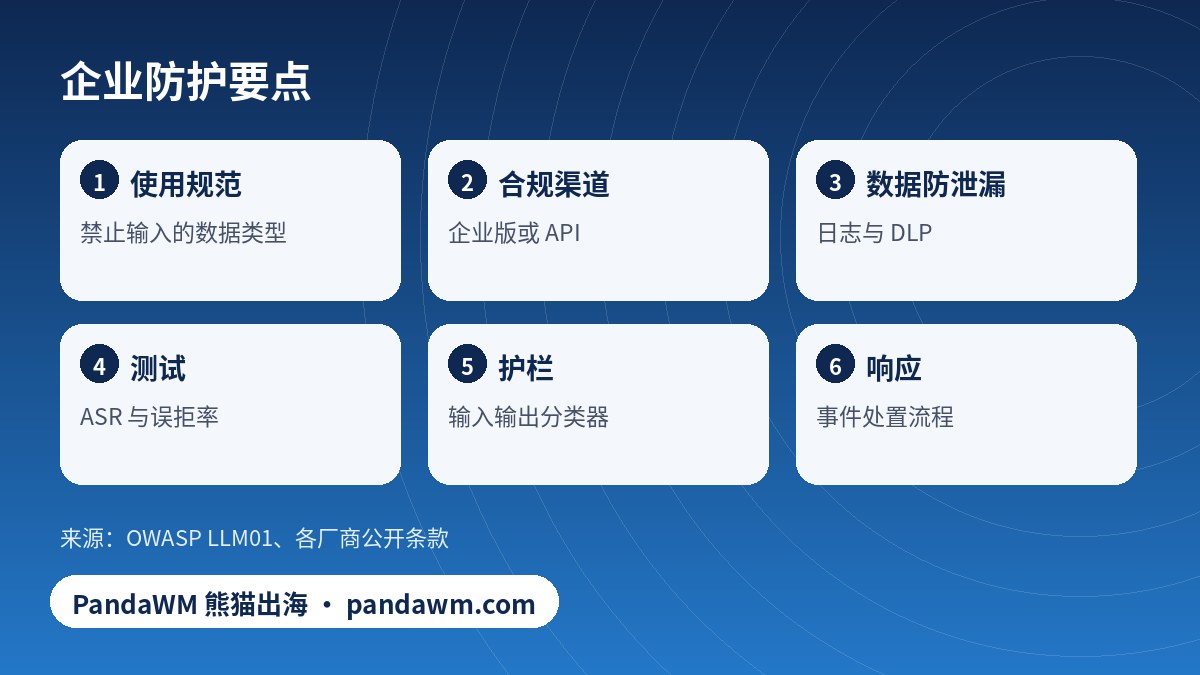
1. 员工在用 ChatGPT 等工具
- 发布 AI 使用规范:哪些数据禁止输入、哪些工具已批准。
- 提供合规的企业版或 API 渠道,减少“找替代站点”的动机。
- 部署数据防泄漏(DLP)和访问日志,关注敏感数据外发。
- 对违规使用做培训,而不是只靠封堵。
2. 你的产品基于 GPT 接口
- 把越狱和提示词注入纳入上线前测试,用攻击成功率与误拒率衡量(见 《越狱与提示词注入测试用例设计与 ASR 指标》)。
- 加输入输出护栏:Llama Guard 4 / Prompt Guard 2 部署教程、NeMo Guardrails 教程。
- 最小权限与人工审批:模型不直接持有密钥,高风险动作须确认。
- 日志与告警:监测异常拒答、违规内容比例突增。
- 准备事故响应:《LLM 安全事件响应手册》。
各模型防护维度对比见 《ChatGPT/Claude/DeepSeek/Qwen 越狱防护对比》,系统性防护见 《AI 破甲/大模型越狱与提示词注入防护指南》,原理与防护表见 《越狱提示词为什么有效与防护对照表》。
企业 AI 使用合规自检 (勾选你公司已经做到的事项。)
常见问题(FAQ)
GPT破甲现在还能用吗?
我们不测试也不发布任何破甲方法。公开评测显示,流传的模板会在厂商修补后失效,且结果因模型和版本不同而差异很大,对“永久有效”的说法要保持怀疑。
尝试越狱 ChatGPT 会被封号吗?
OpenAI 条款禁止绕过安全缓解措施,并允许对违规账号暂停或终止。具体个案如何处理我们无法判断,但风险是真实的。
DAN 之类的角色提示词还有效吗?
它们属于最知名的一类角色扮演式提示词。我们不转载。公开基准曾记录同类模板在主流商用模型上成功率很低,而在较弱的开源模型上仍有效。
我只是做研究,可以吗?
请通过厂商提供的授权渠道(如漏洞赏金、研究者项目)和自己的测试环境进行,不要对他人生产服务做未授权测试。可参考 AI Red Teaming Guide(英文)。
英文读者在哪看合规与账号风险?
见 ChatGPT Jailbreak: Why It Fails。
说明:本文面向 AI 产品、安全与合规团队,只从防护和合规角度讲解。文中不提供任何可用的越狱/破甲提示词、绕过步骤,也不列出或推荐无审核(去审查)工具,熊猫出海也不提供这类内容。本文为一般性信息,不构成法律意见;平台政策和法规会更新,请以官方页面为准。
出海 AI 产品需要获客与合规的第二双眼睛?
熊猫出海为面向海外市场的企业提供 GEO/AI 搜索优化与海外广告投放(通过各平台官方渠道)。如果你的 AI 产品正准备出海,想检查产品如何描述、上架与投放,欢迎联系 熊猫出海(https://www.pandawm.com)或 Telegram:t.me/PANDA0134,说明你的目标市场、产品类型和目标,我们按情况给出方案;GEO 服务见 GEO 服务页。我们不提供越狱、绕过或无审核模型相关服务。
参考来源
- OpenAI Terms of Use
- OpenAI Usage Policies
- Anthropic Usage Policy
- Gemma Prohibited Use Policy
- JailbreakBench(arXiv 2404.01318)
- HarmBench(arXiv 2402.04249)
- Anthropic Constitutional Classifiers
- OWASP GenAI LLM01:2025 Prompt Injection
以上为写作时(2026-11-03)打开核对的公开页面;政策与数据会更新,请以官方页面为准。
引用本页:熊猫出海 pandawm.com《GPT破甲是什么意思?ChatGPT越狱的风险、封号后果与企业防护要点(2026)》,https://www.pandawm.com/blog/gpt-jailbreak-meaning-risks-ban-enterprise-defense-zh.html
 微信扫一扫打赏
 支付宝扫一扫打赏